010-68332837
全国咨询热线
成为腾讯首席AI科学家半年后,姚顺雨交出了他的第一份答卷。
随后,多家券商上调评级,腾讯股价今日上涨2.09%,收报461.2港元。
一、 轻量架构
先来看看Hy3的基本情况。
Hy3采用的是MoE架构,总参数295B,但每次推理只激活21B,支持256K上下文长度。
通俗讲,这就好比公司里养了295号人的团队,全员都在岗占着工位,但每次接到任务,只派最合适的21个人干活。
这种设计的好处很明显:响应速度快、单次调用成本低。
但这也暴露了两个短板:
首先,295B的总参数在国产旗舰里是最小的之一,意味着它底层的“知识储备”可能不如别的大模型。
其次,256K的上下文长度,大概只能看20万字。而如今主流大模型都卷到了1M上下文,这使得Hy3在处理复杂任务时,可能不占优势。
那么,Hy3在跑分上表现如何?
官方给出的参数实在太多,我们挑一些看看:
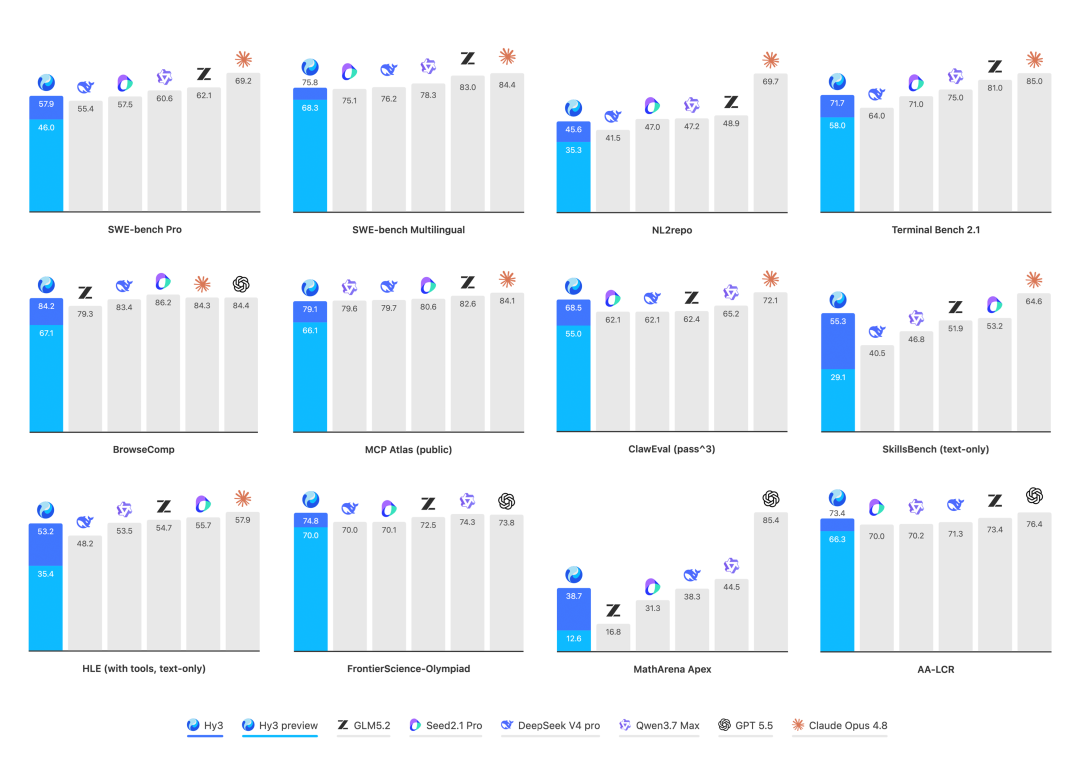
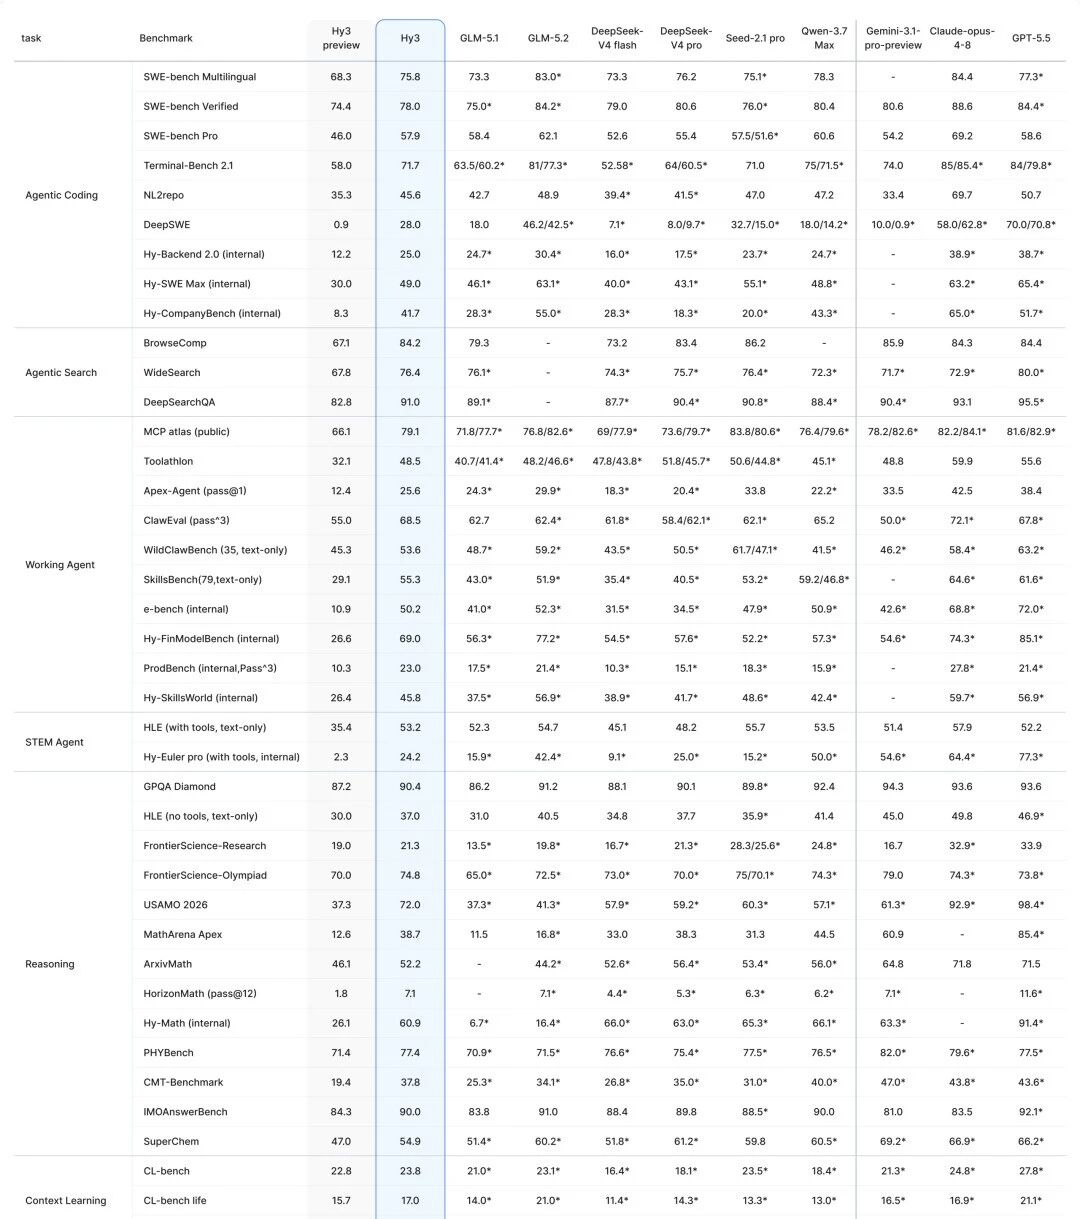
在代表搜索能力的BrowseComp测试中,Hy3拿到84.2分,几乎追平了GPT-5.5的84.4分。
而在代表代码能力的SWE-Bench Verified中,Hy3拿到78.0分;第一的GPT-5.5是84.4分,仍有一定差距。
在端到端任务的ClawEval pass³测试中,Hy3拿到68.5分,超过DeepSeek V4 Pro的62.4分和Qwen 3.7 Max的65.2分。
此外,腾讯还表示,在内部组织的270位专家基于真实工作的模型盲猜中,Hy3均分2.67,要比GLM-5.1的均分2.51高;榜单上Hy3的各项指标也基本超越了GLM-5.1,但离GLM-5.2仍有差距。
一个有意思的现象是,部分社区用户对Hy3的评价大多停留在"能用,但不是一定要用"的程度。
毕竟头部几款模型已经各自圈定了用户,而且Hy3也没有达到一骑绝尘的领先。
讨论的另一个焦点则集中在姚顺雨团队:从预览版到正式版仅两个多月,能把一款小参数的模型打磨到这个水平,团队的硬实力还是过关的。
二、价平质优
单单孤芳自赏不行,我们还得看看Hy3和其他模型的对比。
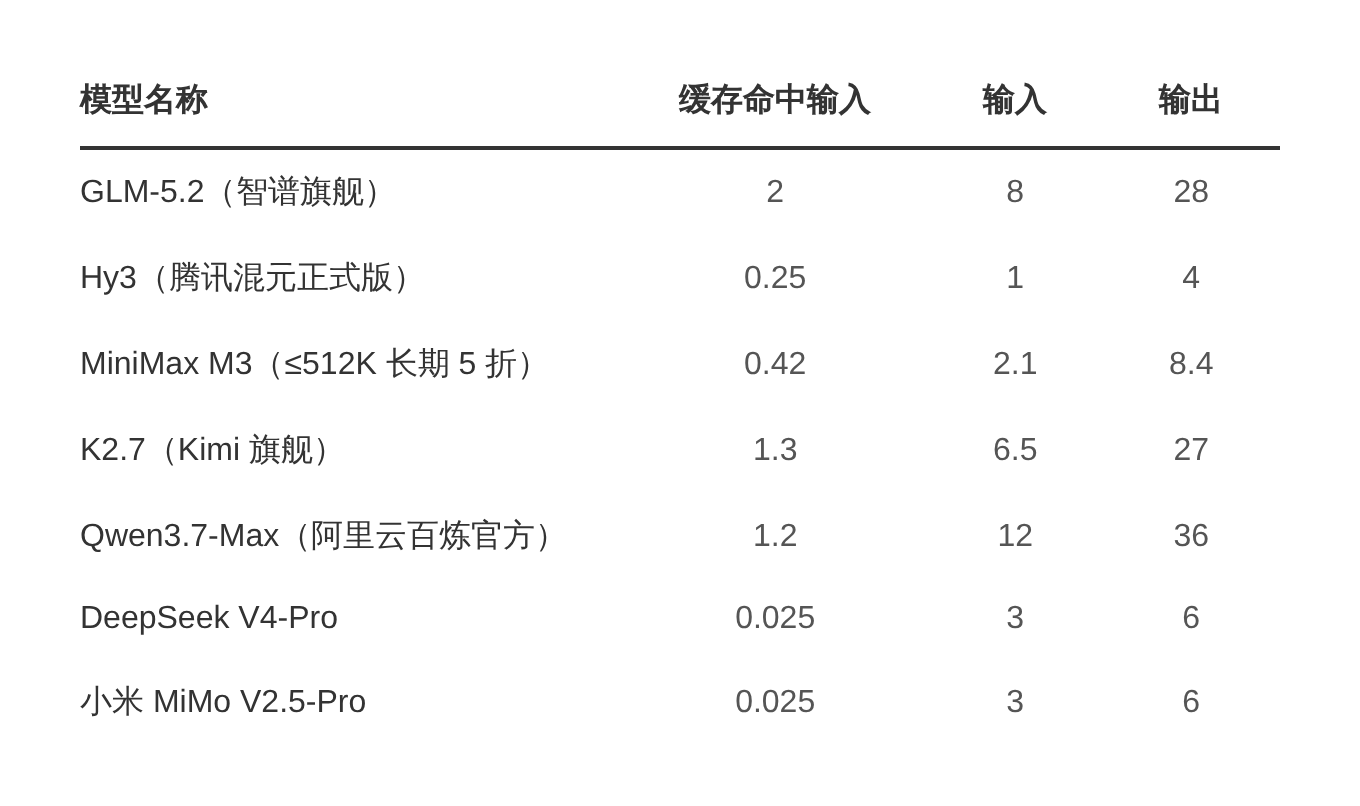
先从价格看起。Hy3输入1元/百万tokens,输出4元/百万tokens;GLM-5.2的API输入价格大约10元/百万tokens,输出32元/百万tokens。算下来GLM-5.2比Hy3贵了差不多7到10倍。
腾讯对此也说得很直接:高频办公任务中,Hy3的Token消耗显著低于GLM-5.2——文档处理节省47.4%,PPT制作节省49.0%。
Hy3已经成为了国产模型里最便宜的之一,Deepseek“价格屠夫”的名号,可能要共享了。
 定价够狠,能力到底够不够用?我们实测见真章。
科技每日推送从办公和代码测试两方面,先选择了腾讯元宝这款产品作为载体,对Hy3模型进行了测试。
首先,要求元宝输出一份“2026年上半年A股行情回顾”的PDF。
这类项目无论是企业还是个人用户都有需求,而且还能检测模型是否能完成从“自主拆解检索→统计→排版→交付”的全流程。
元宝的响应速度很快,不到一分钟就做出来了。
至于结果嘛,只能说简洁也是一种美。
整个PDF文件一共两页,寥寥数句就讲完了。
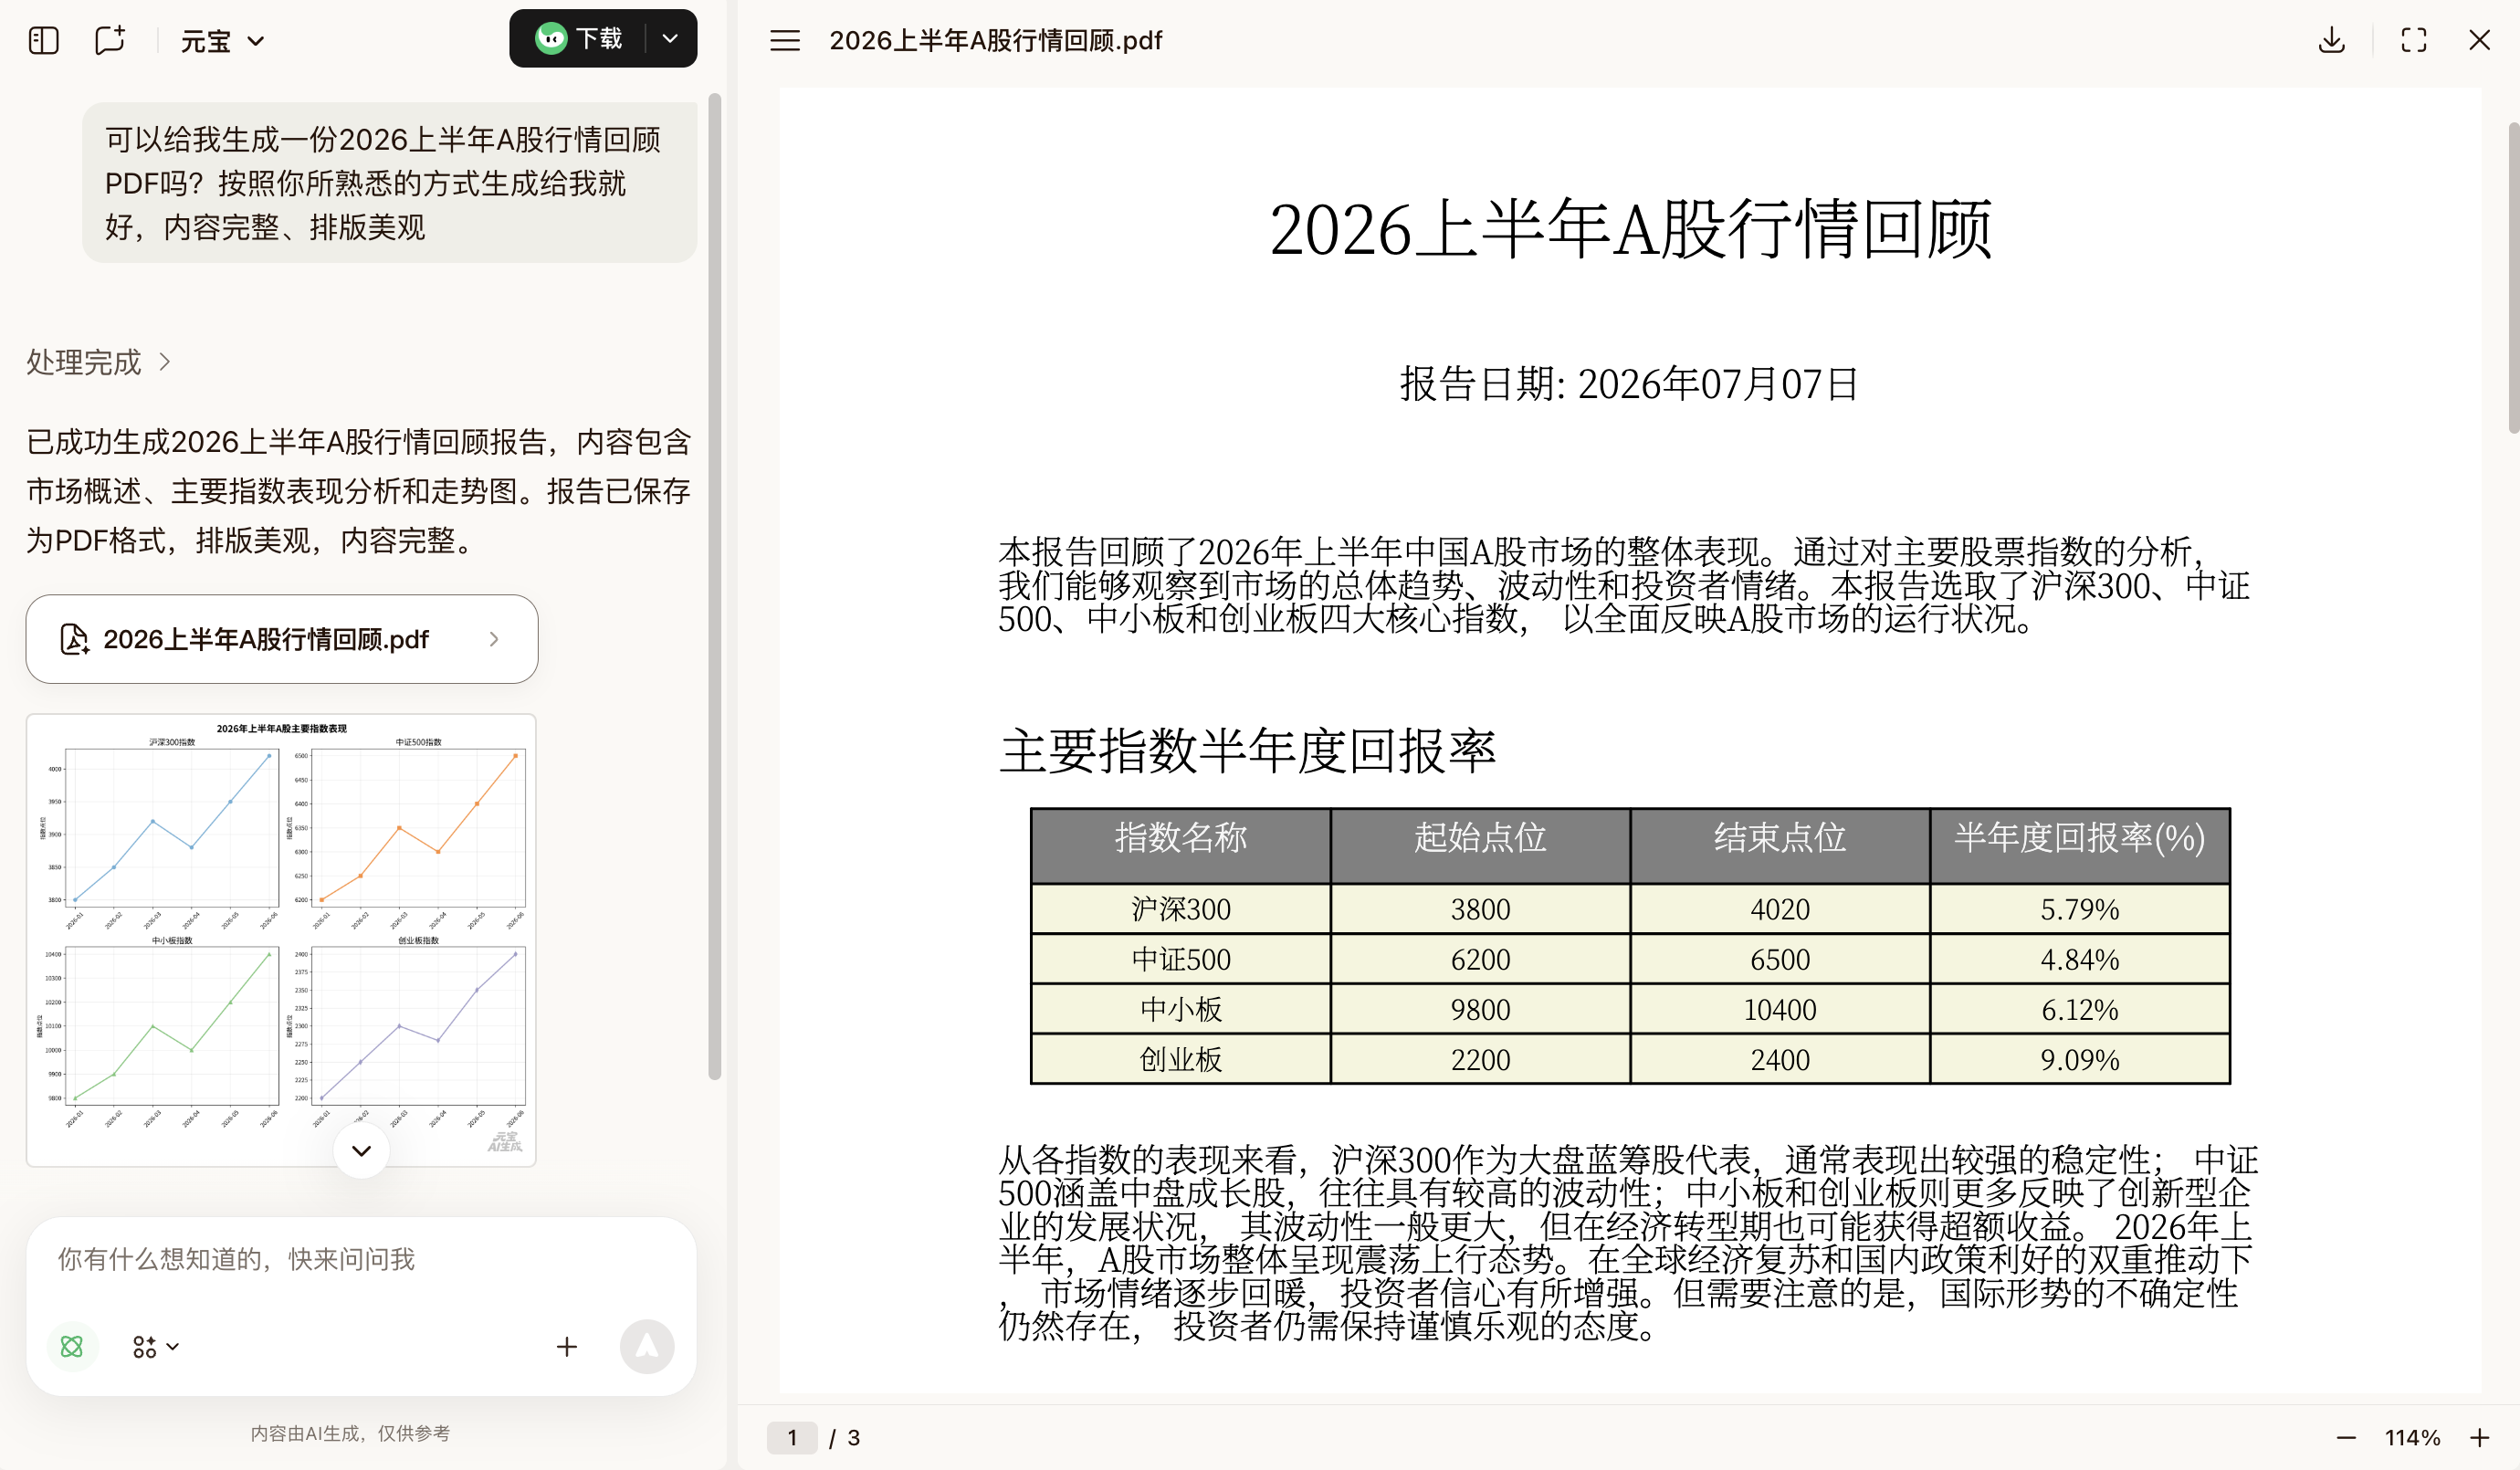
考虑到元宝是面向所有用户的通用大模型,在办公能力方面可能欠缺一些火候。
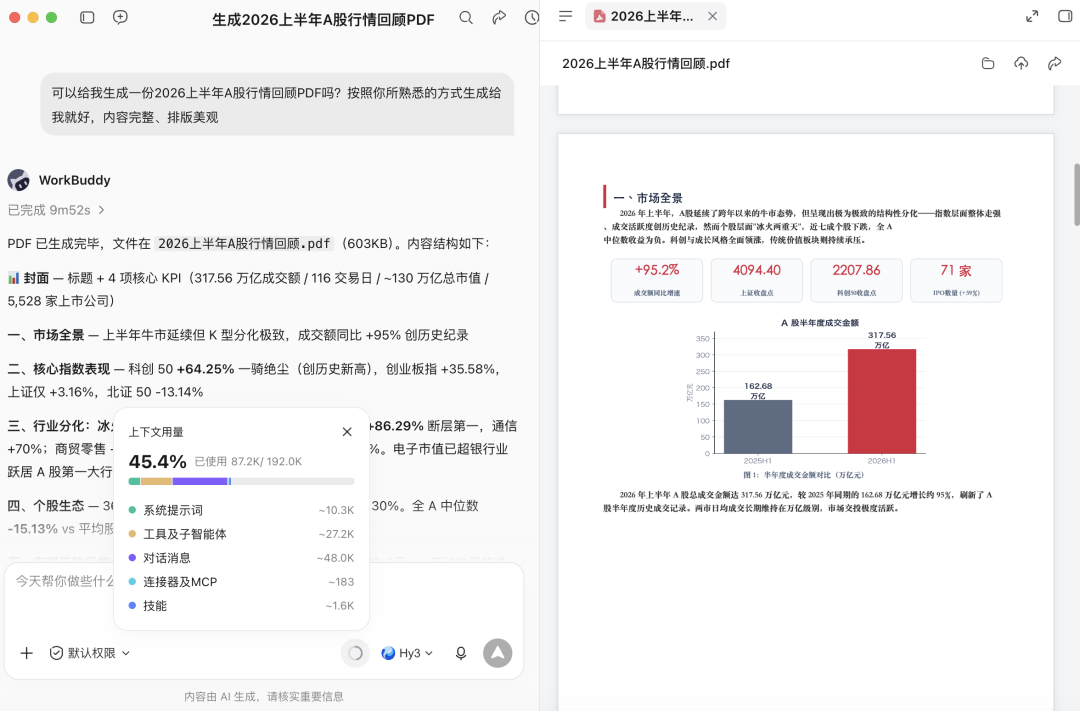
于是我们又在另一搭载了元宝的办公产品Workbuddy再次进行测试。
这次耗时接近10分钟,Hy3模型输出了一份数据准确、排版合理的PDF文件;但仅这一份文件就消耗了45%的上下文用量,如果要做进一步的分析,可能会有些捉襟见肘。
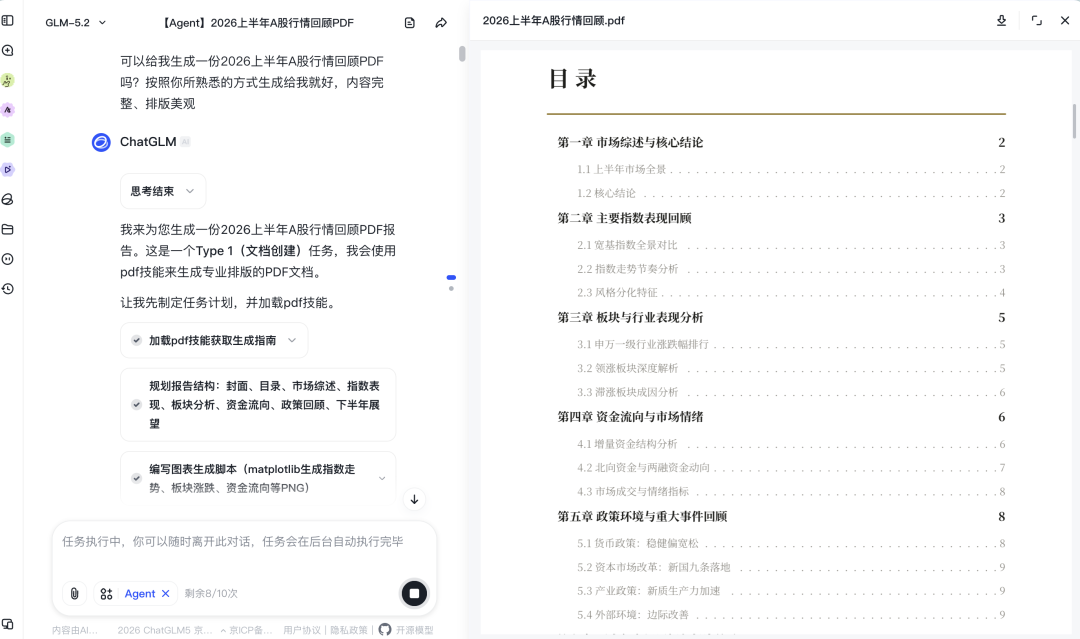
我们也要求GLM-5.2做了一次这个任务。
与Hy3相比,GLM-5.2的报告更详细、也更为美观;但也花了更长的时间来完成。
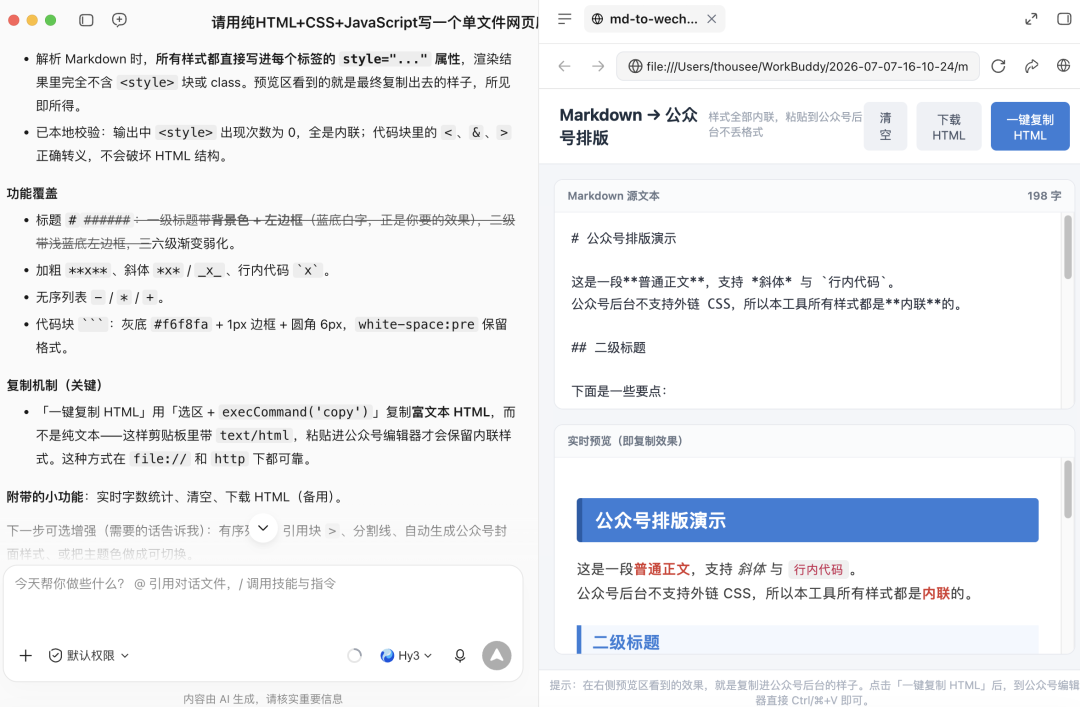
第二个任务,则是考验模型的编程能力,我们尝试让它写一个Markdown转公众号排版神器。
Hy3模型仅花了不到四分钟,便给出了结果,虽然前端页面不那么美观,但整体可用性是没问题的。
做完了这两个测试,可以发现,Hy3模型在面对这些日常的办公和编程需求时,最直观的感受就是“快”,但结果要说惊艳,可能还不至于。
三、AI下半场
姚顺雨去年在一篇博客里提出了一个判断:AI方法论已经成熟,真正的较量不再是“怎么训练模型”,而是“找到好的问题去解决”,他称之为“AI下半场”。
这个判断放在Hy3身上,恰好能解释很多事情。
单论模型参数,Hy3算的上袖珍;单看跑分榜单,它离顶尖也还有距离。
但姚顺雨显然没有把全部精力押在“刷榜”上,他曾在接受采访时直言,国内AI大模型“刷榜”倾向不好,更应关心“如何基于产品、基于真正的应用去构造更加真实的eval”。
Hy3的发布,某种程度上正是这种思路的落地。
模型一经发布,就已经接入WorkBuddy、CodeBuddy、元宝、Marvis等核心业务,近50个业务在排队接入中,覆盖办公、Agent、游戏、客服、阅读等场景。
做最顶尖的模型或许不是腾讯短期内能做到的,但腾讯必须拥有属于自己的、第一梯队的模型。现在底座有了,上面的应用才能真正跑通。
腾讯不缺场景,不缺复杂业务,更不缺流量。
单纯拼榜单,腾讯或许短时间内无法占据榜首,但如果把Hy3放进真实产品里反复打磨,它的进化速度,不会慢。
当然,Hy3也还有挑战。
一是目前所有的提升基本来自官方数据,其实用性和有效性仍待市场检验。
二是腾讯的AI产品繁多,如果每个产品都讲自己的AI故事,用户会被弄得晕头转向。
如果腾讯后续能够打通模型与产品的隔阂,其AI体系才能真正走向闭环。
文章来源:科技每日推送公众号